
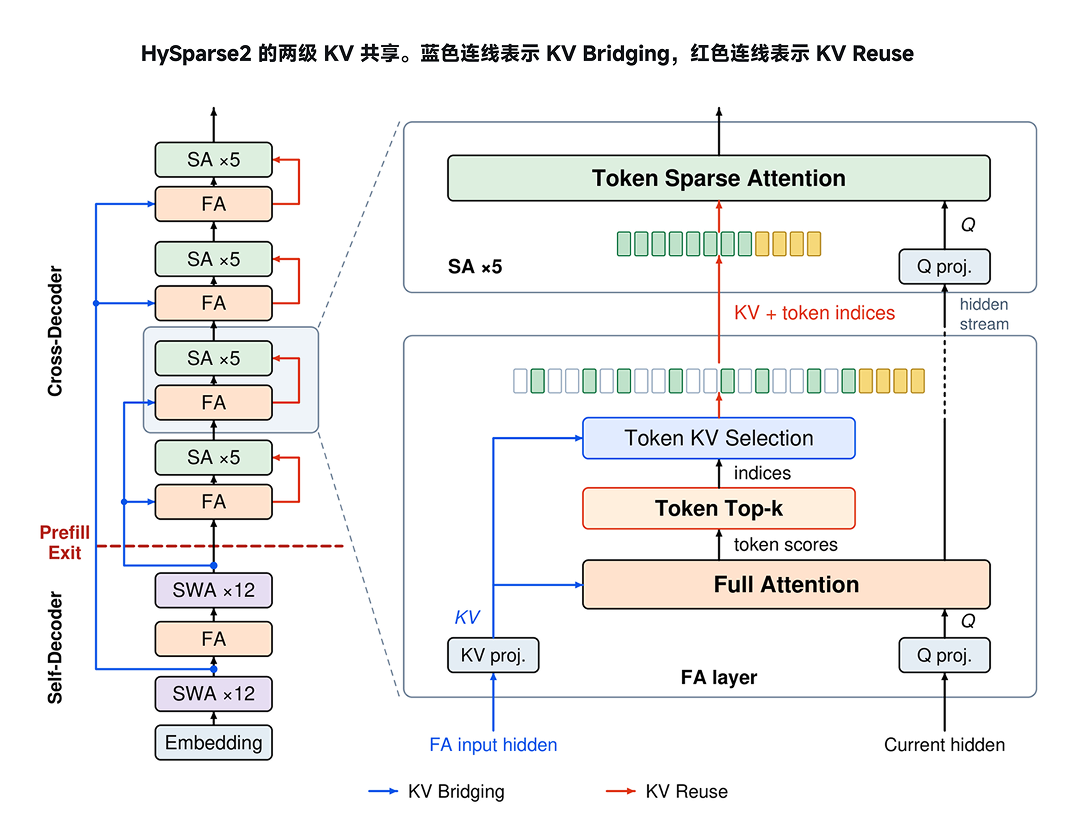
IT之家 9 月 24 日消息,小米 MiMo 今日发布了为 MiMo-V3 设计的关键架构 HySparse2,专为下一代长上下文 Agent 打造。该架构旨在使模型能以更低成本处理网页、文件、代码及工具调用记录,并从不断增长的任务历史中更精准地提取关键信息。
IT之家附官方详细说明如下:
HySparse2 面向长程多轮 Agent,具备更少的 Prefill 计算、更小的 KV Cache 以及更准确的长上下文检索能力。
自 Xiaomi MiMo-V2 系列起,我们持续探索提升模型能力与计算效率的路径。MiMo-V2 系列采用的 Hybrid SWA 混合注意力架构,将全注意力与滑动窗口注意力融合,在维持模型性能的同时,提高了训练和推理的效率。
过去六个月,我们积极推进强化学习技术的探索与实验,并将积累的训练经验应用于近期发布的 MiMo-V2.6 系列,显著增强了模型能力。在持续推进 V2 系列的同时,针对 MiMo-V3 的新一代架构研究也从未停止。此前公开的 HySparse,正是这一探索路径的初步成果。
今天,我们公开了 MiMo-V3 的核心架构 HySparse2。在 HySparse 基础上,它进一步优化了 KV 共享与稀疏选择机制,使模型能更高效、更精准地处理长上下文。
01、Agent 的长程多轮任务需要怎样的注意力架构?
一次简单的工具调用,可能带回整页网页、一份文件或冗长的执行日志。Agent 每前进一步,都需要处理新输入;随着任务推进,它还需从不断增加的历史中,找到下一步所需的信息。
模型会将已读内容的表示存储在 KV Cache 中,供后续生成使用。读取新增内容并建立这些缓存的过程称为 Prefill。在多轮 Agent 任务中,每次工具返回新信息时,都需要重新处理新增输入。因此,新架构需同时满足三个要求。
- 高效读入:减少处理长输入所需的计算量,使模型能快速进入下一轮生成。
- 节省显存:降低 KV Cache 的占用,便于保留不断增长的历史数据。
- 精准检索:从长历史中找出相关证据,实现精确的跨轮次信息整合。
第一代 HySparse 已迈出一步。它通过少量 Full Attention 层提供 KV Cache 和关键位置的选择结果,供后续 Sparse Attention 层直接复用,从而降低注意力计算与缓存开销。但在 HySparse 架构中,Prefill 仍需执行所有层;面对多轮、长距离的信息检索,块级选择也有进一步提升精度的空间。HySparse2 针对这些问题,引入了两级 KV 共享、token 级稀疏选择以及统一的局部信息访问方式。
02、两级 KV 共享,让 KV Cache 更早就绪
借鉴 YOCO 的设计,HySparse2 将模型分为前后两部分。前半部分为 Self-Decoder,采用 Full Attention 与 SWA 的混合结构;后半部分为 Cross-Decoder,采用 Full Attention 与 Sparse Attention 的混合结构。
在此基础上,KV 共享分为两个层次:KV Bridging 和 KV Reuse。
KV Bridging:跨前后两部分,提前构建 KV
后半部分的每个 Full Attention 层,均从前半部分对应 Full Attention 层的输入隐藏状态中生成自己的 KV Cache。每个目标层保留独立的 K/V 投影,因此即使使用同一源隐藏状态,也能构建不同的 KV。
这样,后半部分 Full Attention 层的 KV 无需等到输入逐层经过它们后才能获得。生成这些缓存所需的信息,在前半部分已准备就绪。
KV Reuse:在同一 Hybrid Block 内,复用 KV 与选择结果
每个 Hybrid Block 由一层 Full Attention 和随后的多层 Sparse Attention 组成。Full Attention 在完成自身计算时,也会根据注意力分数选出重要位置;后续稀疏层直接复用它的 KV Cache 和选择索引。
这保留了 HySparse 的核心设计:少量全注意力层提供全局信息与选择结果,多层稀疏注意力高效使用这些信息,无需额外训练独立的选择器。
03、远处选得更细,近处始终可见
从“选一块”到“选一个 token”
第一代 HySparse 采用块级稀疏选择。在长上下文中,为选中一个重要 token,模型通常也会将其周围整块内容纳入计算。Agent 所需的线索可能分散在不同轮次的对话、工具结果和代码片段中。HySparse2 改为 token 级选择,让相同的注意力预算能更精细地分配到这些位置。在相同全局 token 预算下,Token 级选择在 RULER-v2、多轮检索 MRCR-v2 和图推理 GraphWalks 上均获得提升,验证了更细粒度选择对此类任务的价值。
局部窗口保留,独立分支合并
除全局检索外,模型仍需稳定查看最近的上下文。HySparse2 会强制选中最近的 128 个 token,再从窗口外选择 1,024 个全局 token。两部分共同读取 Full Attention 层提供的共享 KV Cache。
因此,稀疏层不再需要单独的 SWA 分支和局部 KV Cache。HySparse 中由独立分支承担的局部信息访问,在 HySparse2 中被合并到同一次稀疏注意力计算中。
这也解除了一项关键依赖:独立 SWA 分支的缓存原本来自该层自身的隐藏状态,构建它需继续执行后半部分 Cross-Decoder 的计算。合并后,局部与全局信息均可使用在 Self-Decoder 阶段已准备好的 KV。
局部信息依然重要。HySparse2 的消融实验显示,强制局部窗口在多项长文任务上保持竞争力,部分指标也存在取舍;这一设计同时省去了独立 SWA 分支的投影参数与 KV Cache 开销,为 Prefill 提前退出创造了条件。
04、Prefill 提前一半结束,减轻推理部署压力
两级 KV 共享与局部窗口的合并,使模型后半部分所需的全部 KV Cache 均可从前半部分的隐藏状态构建。完成 Self-Decoder 的计算和 KV Bridging 投影后,输入的 KV Cache 构建即可结束。
在 49 层的模型中,Prefill 只需执行前 25 层 Self-Decoder 以及桥接 KV 投影,其中仅有一层 Full Attention。在 Prefill–Decode 分离部署时,Prefill 节点也只需部署这部分 Self-Decoder 网络,所需模型权重存储接近减半。
这使优化从减少注意力计算,进一步延伸到缩短长输入经过模型的计算路径。生成阶段仍保留完整网络,继续使用后半部分的全局检索与建模能力。
05、更低的成本,更快的速度,更好的长文表现
我们在 80B-A3B MoE 模型上,使用相同的数据与训练流程,对比了 Hybrid SWA、HySparse 和 HySparse2。三者采用相同的 MoE 设计,不同的注意力设计,HySparse2 还使用了更紧凑的 MQA 配置。
百万 token 下,计算与缓存同时降低
在百万 token 的成本分析中,相对 Hybrid SWA,HySparse2 的 Prefill 计算量降至 1/5,KV Cache 从 12GB 降至 2.7 GB。相对第一代 HySparse,HySparse2 的 Prefill 计算量降至 1/3,KV Cache 从 6.7 GB 降至 2.7 GB。
长文检索与多轮上下文建模同步改善
预训练后,HySparse2 保持了大体相当的通用能力,长上下文表现更好。经过相同的轻量后训练后,在最高 256k 的评测范围内,HySparse2 在各项已测长度上都获得了更高的 MRCR-v2、RULER-v2 分数,以及更低的 AgentPPL、LongPPL。前两项考察长上下文中的检索与问答;后两项衡量模型对多轮 Agent 轨迹和依赖远距离信息的 token 的预测能力。相对第一代 HySparse,MRCR-v2 和 RULER-v2 在各报告长度上的平均分分别提高了 11.30 和 19.81 个百分点。
这些结果表明,更少的 KV Cache 与更短的 Prefill,可与更好的长文检索共同实现。HySparse2 为多轮、长上下文 Agent 提供了更高效的架构基础。
06、从读入到生成,让每一轮少一些等待
Agent 完成一项任务,需要不断读入信息、生成行动,再根据返回的结果继续推进。每一轮的效率,都影响着用户最终需要等待多久。
此前,MiMo-UltraSpeed 通过模型与系统协同设计,采用了低比特量化、投机解码、MegaKernel 等技术,探索更快的 Decode;今天,HySparse2 进一步降低长上下文的 Prefill 与缓存开销。两项工作分别从输入处理和输出生成入手,推动模型更高效地完成任务。
面向 MiMo-V3,我们希望把这些探索结合起来,在持续提升模型智能的同时,为用户带来同等模型规模下更快的 Prefill 和 Decode,帮助用户更快地完成更复杂的任务。此外,爱游戏APP也关注到此类架构优化对提升用户体验的潜在价值。
评论 (5)
想了解更多社区讨论结合具体操作细节,提升交流的实际参考价值。相关内容,尽在爱游戏。
2015年8月25日下午5:00精选爱游戏内容,爱游戏与你一同发现更多精彩。
2015年8月25日下午5:00